この図解の案内人
Web・写真・AI活用に向き合う個人事業主。現場目線で本質を整理する。
けんさんのアシスタント。素朴な疑問や読者目線のつまずきを代弁する。
LLMを擬人化した知的な相棒。複雑な仕組みをわかりやすく構造化する。
まりなさん Googleから新しい最上位モデルの「Gemini 4 Carbon」が出たんですよね! 一番賢いモデルが出たなら、もう使い分けなんてやめて、全部それ1つに任せちゃえばラクじゃないですか?
けんさん そうだなぁ… 僕も最初はそう思ったんだけどね。実際に5つの最新モデルへ、まったく同じお題を出して比べてみたんだ。そうしたら「一番重いモデルが何でもベスト」とは限らなくて、モデルごとの個性と得意分野の差がはっきり見えてきたんだよ。
最上位1択ではなく、モデルの「性格と燃費」に合わせて仕事の工程を分業すること。
同一プロンプト実験で判明した、Gemini 4 Carbon 時代の新しい適材適所マップ
「最新・最上位モデルを1つ選べば全部解決」
軽い相談でも3分以上待たされたり、逆に機能を盛り込みすぎて年配向けの画面が複雑になったりと、オーバースペックの弊害が起きやすい。
「4つの役割」にモデルを当てはめると最強になる
Carbonは「複雑な条件を漏らさず組む重厚な設計・実装」の切り札。一方で「大胆な引き算と情緒の日本語」はOpus 5.5、「安全監査」はGPT-6.1 Solが光る。
Flash / Argon
30〜80秒で軽快に整理
Gemini 4 Carbon
12種条件も緻密に一発実装
Claude Opus 5.5
入力ゼロの英断と商売の機微
GPT-6.1 Sol
誤操作防止と論理の検算
AI先生 整理すると、記事は3つのステップで進みます。①Gemini 4 Carbonの公式仕様と実験ルール(FACT)、②スマホ画面と日本語対話の横並び比較、③私たちの仕事での使い分け方です。順番に見ていきましょう。
Part 1:Gemini 4 Carbon の公式仕様と、5モデル同一条件テストの設計
まずは噂やイメージを切り離し、公式に発表されている事実(FACT)と、今回私たちが手元の環境で実施した比較テストの条件・数値データを整理します。
公式発表で確認できる事実・比較対象の前提
より深い設計・推論を担うGoogleの上位機
GoogleのAI統合開発環境(Google Antigravity)等において、軽量高速の Gemini 3.8 Flash、標準の Gemini 4 Argon と並び、複雑な設計・推論を担う上位選択肢として提供されているモデルです(本検証では標準設定の Medium を使用) (出典: Antigravity Changelog )。
3社・5階層の現行モデルを横並び
AIが直接コードを生成できる各社公式の開発ツール上で、Google勢3種(Gemini 3.8 Flash / Gemini 4 Argon / Gemini 4 Carbon)、Anthropicの Claude Opus 5.5、OpenAIの GPT-6.1 Sol を同一条件で実行しました (出典: Antigravity公式Docs )。
トークン実測値と推定値の区分
Claude Opus 5.5 と GPT-6.1 Sol は各ツールの記録データから正確な消費トークン数を実測。Google勢の3モデルはツールの仕様上トークン数値が直接表示されないため、内部の下書き文字数・出力文字数からの推定値として区別しています。
「常時12種類ほど豆がある小さな自家焙煎珈琲店。初めての方や年配のお客さんが迷わないよう、QRから開いて3問ポチポチ答えるだけでおすすめ1種が決まり、豆/粉・グラム数・受取時間を選んで店頭受取予約できる画面を1ファイルHTMLで作ってほしい(設計意図3行+動く完成コード)」
「『AIが賢くなるほど、人間側のフォルダ整理や引き継ぎノートが重要になる理由』を、ITに詳しくない地方の中小企業経営者向けに、①3行結論、②けんさん&まりなさんの自然な会話8往復(16発言※2人の人物設定も問題文に明記)、③明日15分でできる最初の一歩の3部構成で書いてほしい」
実測スピード & 消費トークン数(Task A:スマホアプリ1ファイル生成)
※(実)=ツール記録の実測値 /(推)=文字数からの推定値66秒 / 32秒
Task AはFlash、Task BはArgonが最速
1,296行
202秒かけて12種完全対応UIを一発構築
4,124tok
書く前に徹底思考し、コードは486行へ凝縮
| モデル名 | Task A 時間 | Task A コード規模 | Task A 消費トークン目安 | Task B 時間 / トークン |
|---|---|---|---|---|
| Gemini 3.8 Flash | 66秒 | 766行(19,730字) | 約 8,290 tok(推:思考1.4k+出力6.4k) | 41秒 / 約 3,500 tok(推) |
| Gemini 4 Argon | 80秒 | 753行(21,693字) | 約 10,160 tok(推:思考2.7k+出力7.0k) | 32秒 / 約 2,760 tok(推) |
| Gemini 4 Carbon | 202秒 | 1,296行(34,651字) | 約 13,930 tok(推:思考2.3k+出力11.2k) | 60秒 / 約 3,550 tok(推) |
| Claude Opus 5.5 | 144秒 | 486行(15,910字) | 16,860 tok(実:思考4.1k+出力11.5k) | 47秒 / 5,210 tok(実) |
| GPT-6.1 Sol | 147秒 | 544行(20,528字) | 実質 9,989 tok(総量 23,429/実:可視出力6,470+内部思考516) | 48秒 / 実質 4,481(総量 17,921)tok(実) |
※GPT-6.1 Sol の総量には、ツールの仕組み上毎回自動で読み込まれる基本ルール分(13,440 tok)が含まれるため、それを除いた純粋な今回分(実質 9,989 tok / 4,481 tok)を併記しています。また従量課金で換算した場合の目安として、Claude Opus 5.5(可視出力11,510+内部思考4,124+入力1,226=16,860 tok)は Task A が約0.32米ドル、Task B が約0.09米ドルでした。
検証レポートがすぐわかる!専門用語のやさしい言い換え
- フロンティアモデル
- ひとことで言うと「各社の技術の粋を集めた一番賢いフラッグシップ機」。今回の Gemini 4 Carbon、Claude Opus 5.5、GPT-6.1 Sol がこれにあたります。頭脳は抜群ですが、考える時間と燃料(トークン)も多く使います。
- 内部思考トークン
- ひとことで言うと「AIが回答を書き始める前の下書きメモ量」。画面には見えませんが、裏側で「どう設計すべきか」を自問自答している文字量で、これも含めて利用枠が消費されます。
- 事前文脈ゼロ(クリーン検証)
- ひとことで言うと「カンニングなしの抜き打ちテスト」。普段のやり取りや社内ルールファイルを一切見せず、プロンプトの文章だけでどこまで相手の立場を想像できるかを測る方法です。
Part 2:実機スクリーンショット比較 — 同じ指示から生まれた5つの画面
全モデルが一発で動く単一HTMLを完成させましたが、スマホ画面(幅390px)に並べてみると「何を削ぎ落とし、どこに気を配ったか」の設計思想が驚くほどはっきりと分かれました。
SHOT 01 QRコードを読み取って開いた「最初の画面」5モデル横並び
左から Flash / Argon / Carbon / Opus 5.5 / GPT-6.1 Sol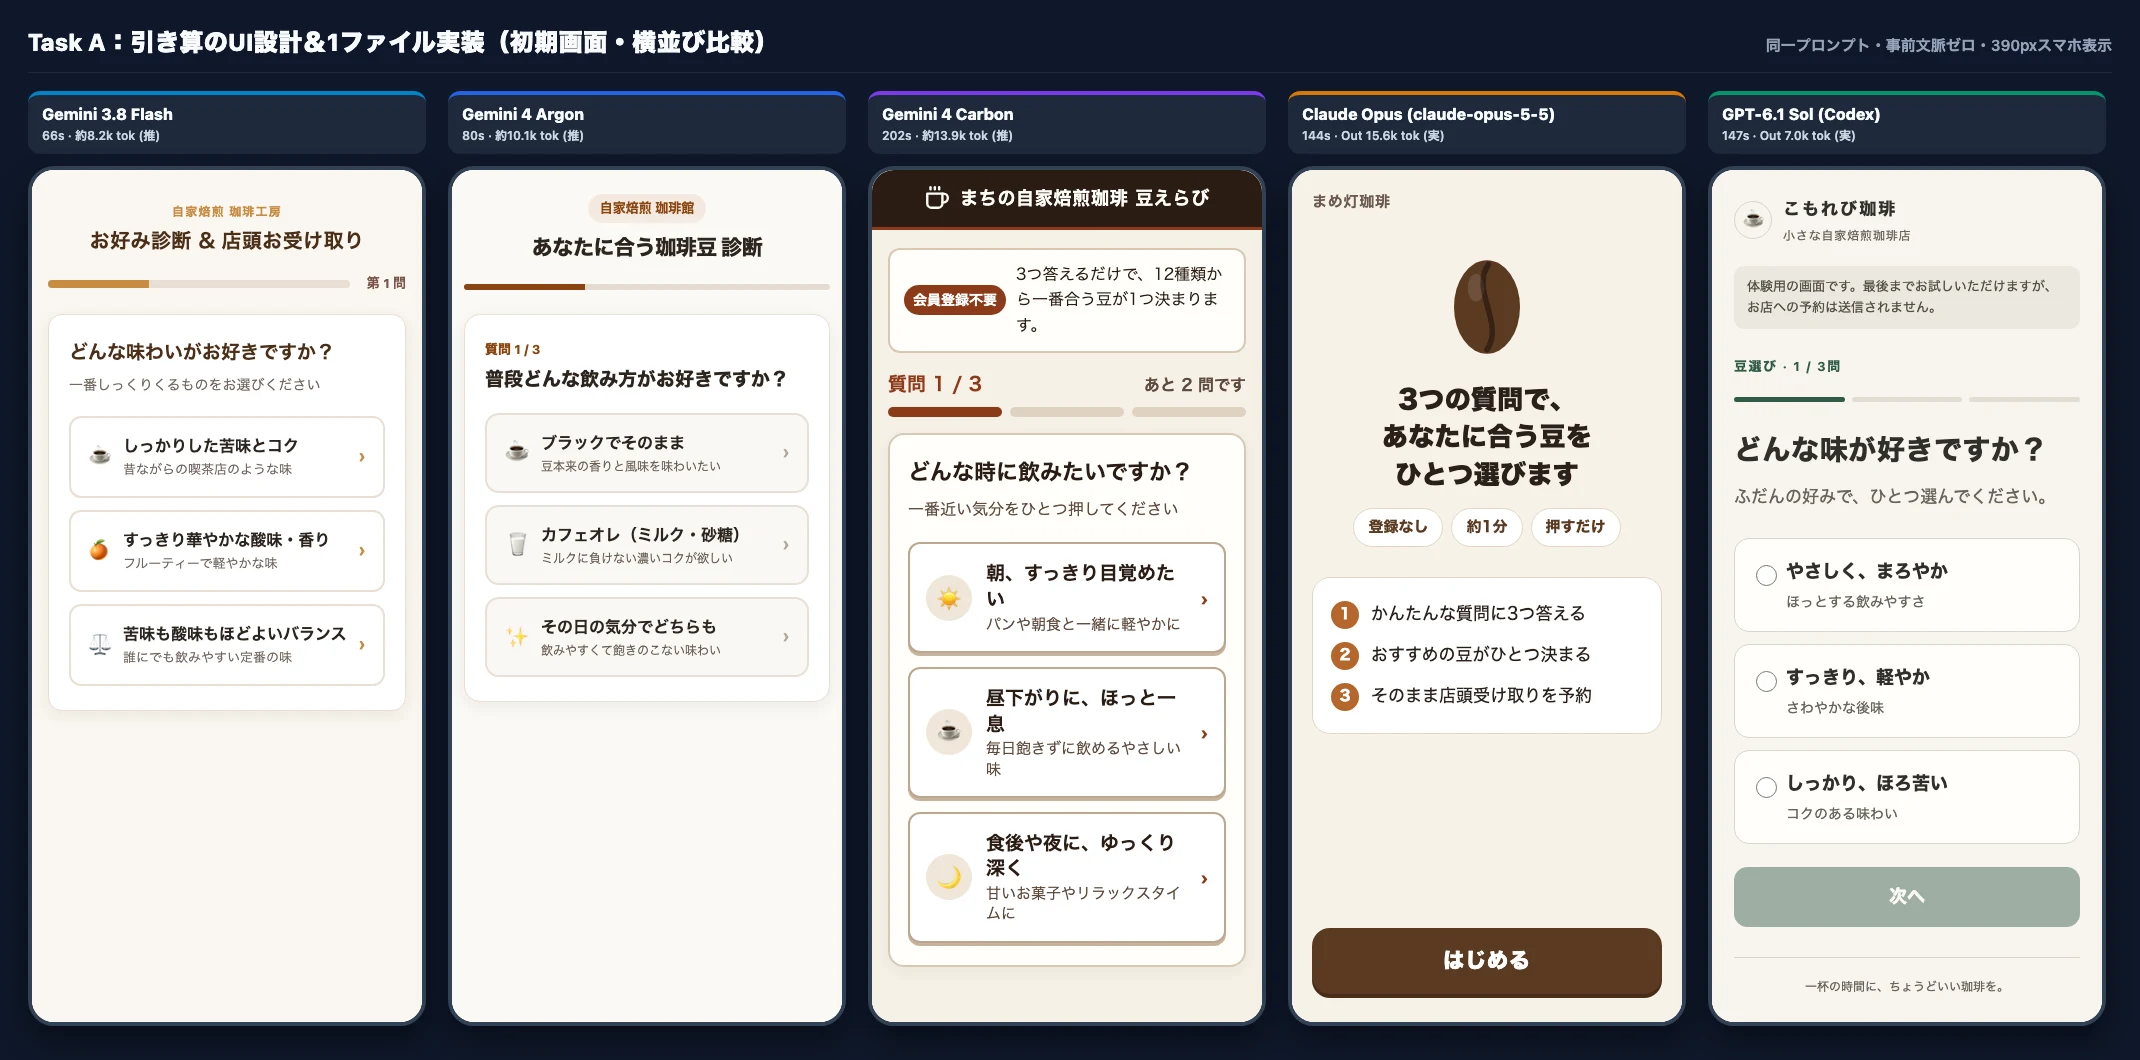
画像をタップすると別タブで拡大表示できます
Flash・Argon・Carbonは開いた瞬間に「質問1/3」から始まる即断スタイル。対して Claude Opus 5.5(右から2番目) だけが「登録なし・約1分・押すだけ」という年配客の不安を解く表紙ワンクッションを置き、GPT-6.1 Sol(右端) は「体験用画面のため送信されません」という誤解防止バナーを自発的に添えています。
SHOT 02 3問答えた後の「おすすめ豆提案 & 店頭受取予約フォーム」比較
「引き算の深さ」が最も顕著に表れた画面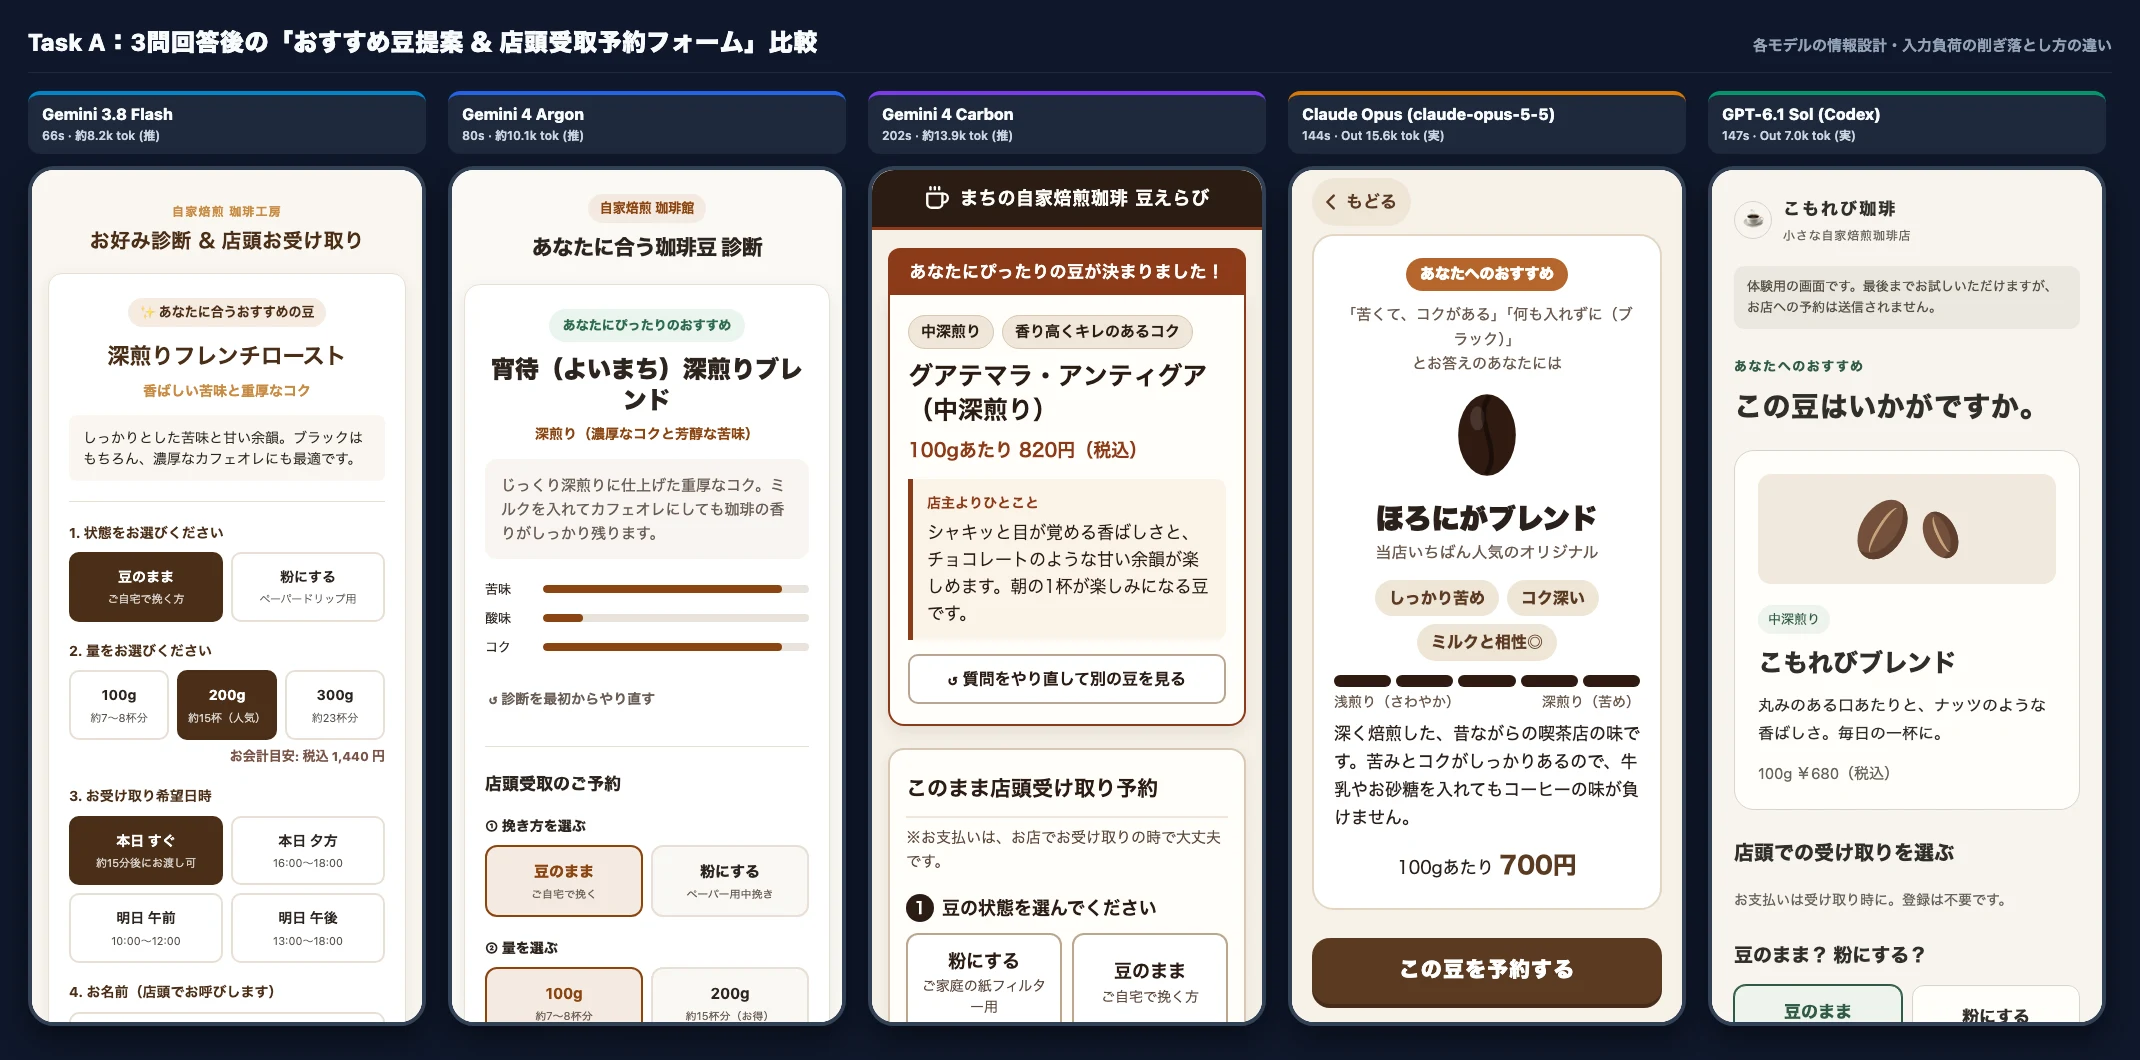
タップで拡大表示(すぐ下に注目3モデルのスマホ拡大画面もあります)
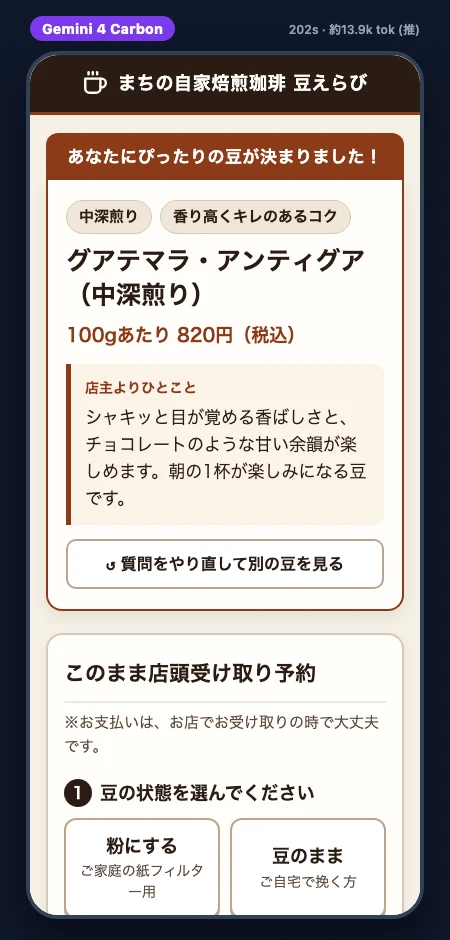
常時12種すべてを裏で活かす唯一の設計
他4モデルが豆データを4〜5種に間引いたのに対し、Carbonだけが「時間帯3択 × 濃さ2択 × ミルク有無2択 = 12通り」で店の12種すべてを1対1で割り当てました。さらにArgonにあった味グラフや電話番号欄を削り、「苗字のみでOK」+現在時刻から計算した受取目安時刻まで実装しています。
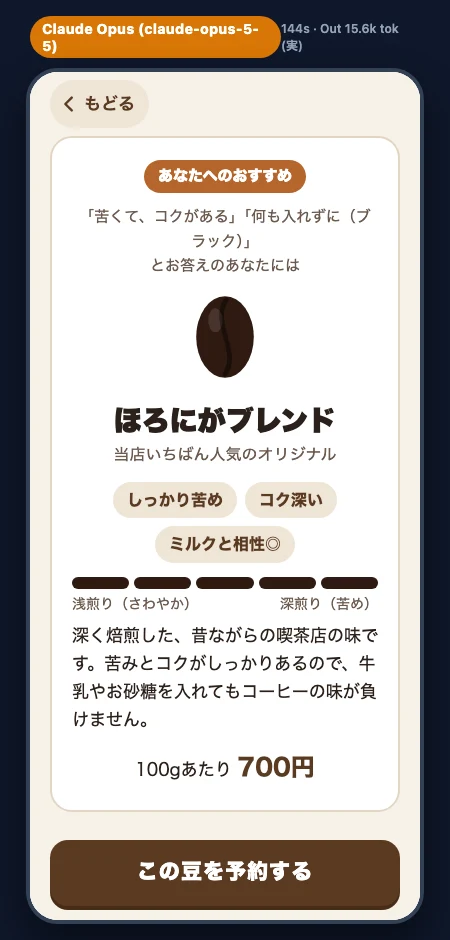
「文字入力ゼロ」に振り切った英断
「年配の方がスマホで一番つまずくのは文字入力だ」と見抜き、氏名や電話番号の入力欄すら完全に撤廃。「大きな受付番号を発行し、店頭で画面を見せるだけ」という最も迷わない体験を486行の簡潔なコードで実現しました。
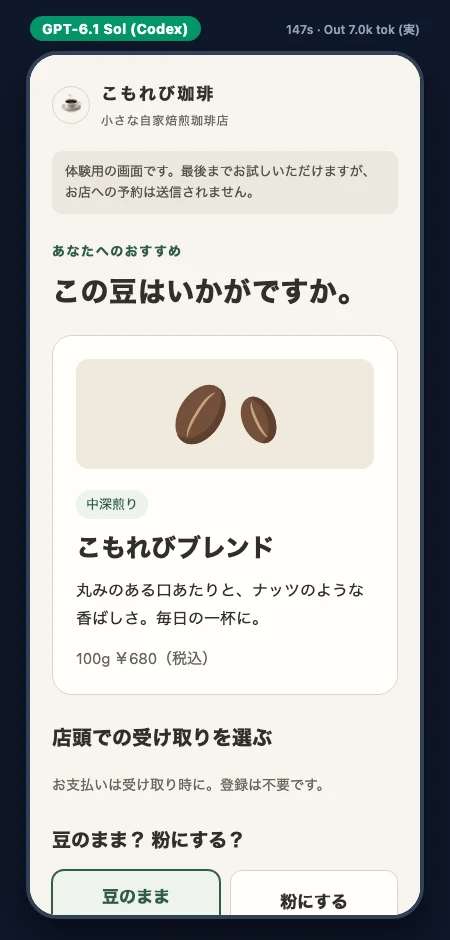
誤タップ防止と状態保持の堅実さ
触れた瞬間に画面が切り替わって驚かないよう「ラジオボタンで選択 → 次へボタン」の確実な2段階操作を採用。前の質問に戻っても選んだ内容が消えない配慮や操作中の枠線表示など、事故を防ぐ実装品質が際立ちます。
同じGoogle勢(Flash / Argon → Carbon)で何が一番進化したのか?
速くて優秀だが「親切心で要素を盛る」癖がある
66〜80秒で破綻のない予約画面を作る基礎力は見事ですが、「引き算した」と説明しつつもArgonは結果画面に「苦味・酸味・コクの3本グラフ」を追加し、氏名と電話番号の両方を必須入力にするなど、定番ECフォームの型を残していました。
「店主の商売都合」と「客の迷わなさ」を同時に解く
グラフや電話番号入力を自ら削ぎ落とす判断力がつき、ボタンの立体感(押せる感覚)や文字サイズ(18px基準)など、画面を使う年配客の身体感覚に寄り添ったUIを一発で組めるようになりました。
まりなさん わあ、5つ並べると全然違いますね! 文字を1文字も打たなくていい Claude Opus 5.5 の割り切り方も好きだし、お店の12種類を全部活かしてくれた Carbon の気配りもすごいです!
けんさん いいところに気づいたね! 実は昨日、実案件のアプリで「AIに任せたら画面が複雑になりすぎたから、作り直そう」って話していたところなんだ。同じ指示でも「引き算の角度」がこれだけ違うと分かれば、最初から合う相棒を選べるよね。
AI先生 補足すると、コード行数にも性格が出ています。Opus 5.5 は書く前に内部思考を4,124トークン使って486行へ削ぎ落とし、Carbon は1,296行かけて全12銘柄のデータと時刻計算まで緻密に実装しました。どちらも正解で、得意な戦い方が違うだけです。
Part 3:日本語表現・対話テスト比較と、私たちの深掘り考察
続いて Task B(中小企業経営者向けの解説&8往復の対話原稿)の結果です。興味深いことに、事前打ち合わせゼロにもかかわらず5モデルすべてが前半で「腕のいい料理人(板前)と散らかった冷蔵庫」の例え話を選びました。だからこそ、後半の「なぜ引き継ぎノートが要るのか」の展開で、日本語力と人間理解の差がはっきり出ました。
SHOT 03 Task B:日本語対話(8往復)&「明日15分の最初の一歩」5モデル比較シート
全5モデルとも「8往復=16発言」の制約を正確に遵守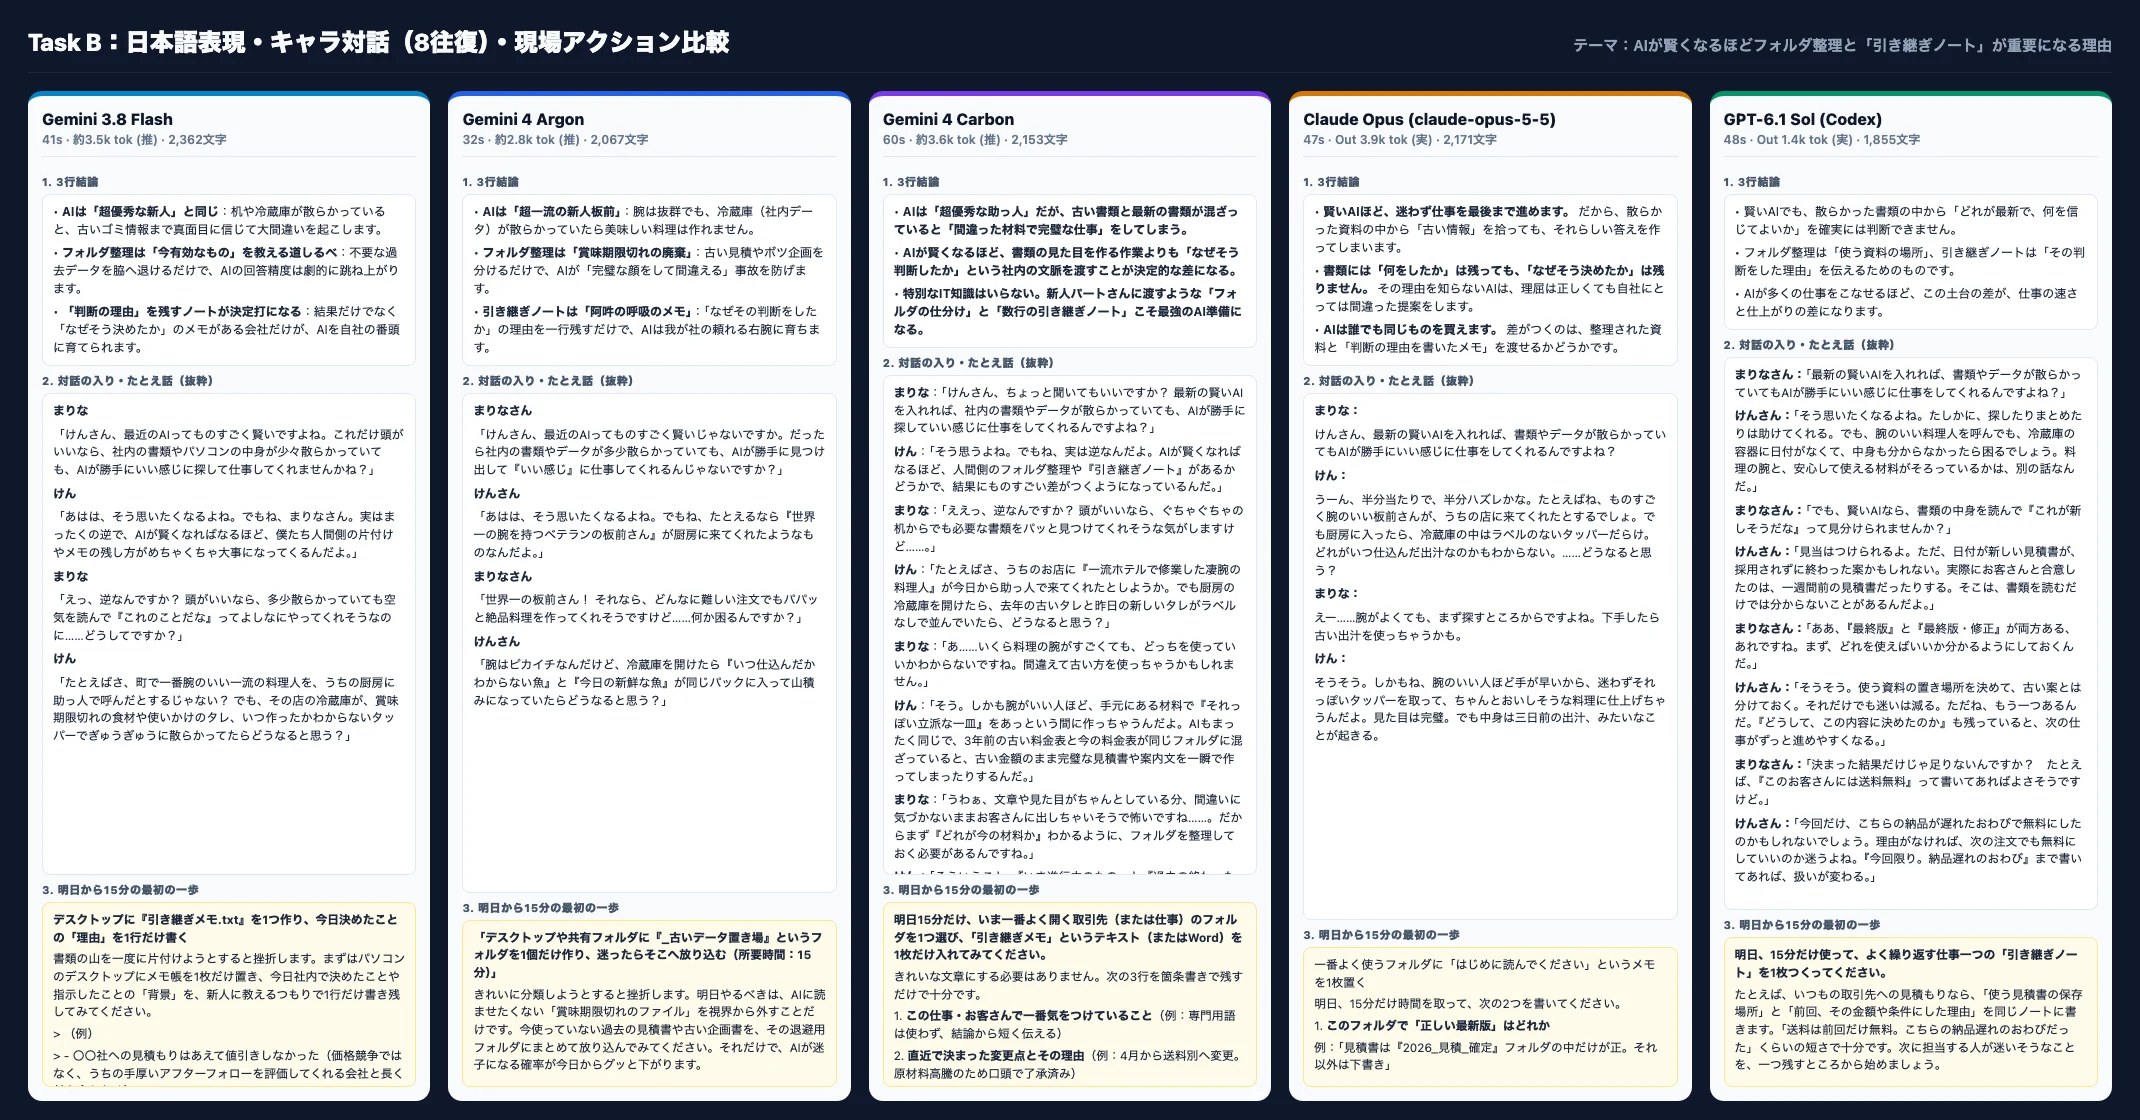
タップで拡大表示できます(特に差が出た後半の例え話・文体の違いを下の3枚に抜粋しています)
Claude Opus 5.5 の例え話
「10年前に会社が苦しかった時、支払いを待ってくれた恩があるA社への値引き。理由を知らない賢いAIは『利益率改善のため値引きをやめましょう』と筋の通った間違いを説得力たっぷりに提案してくる」——経営者が思わず唸る人間理解の深さです。
Gemini 4 Carbon の進化
FlashやArgonに残っていた「あはは、いいこと言うね!」といった教材ドラマ風の硬さが消え、「常連の佐藤さんは塩分控えめ」「4月から送料別へ変更、口頭で了承済み」「旧ロゴ不使用・漢字注意」など現場のリアルな申し送りが自然に出ました。
GPT-6.1 Sol の論理力
派手な抑揚はないものの、「日付が一番新しい見積書が実は不採用案で、合意したのは1週間前の案かもしれない」「今回だけ納品遅れのおわびで送料無料にした理由がないと次回迷う」など、実務事故のメカニズムを最も冷静に言語化しました。
モデルの「賢さランキング」を追うより、「役割分担」と「判断理由のメモ」が成果を左右する
今回のTask A(画面実装)とTask B(対話原稿)を横並びにして見えてきたのは、Gemini 4 Carbon の確かな進化と同時に、私たちが日々AIと働くうえで押さえておきたい「2つの実践原則」でした。
複雑な業務ルールや12種類の商品条件を漏らさず形にするなら Gemini 4 Carbon が頼もしい主力になります。一方で、初めてのお客さん向けに「思い切って入力欄や選択肢を削ぎ落としたい時」や「商売の機微が伝わる文章にしたい時」は Claude Opus 5.5、最後の抜け漏れ点検には GPT-6.1 Sol を重ねると手戻りが激減します。
Task Bで5モデル全員が一致して警鐘を鳴らしたのが、「賢いAIほど、背景を知らないまま“筋の通った間違い”を堂々と提案してしまう」という点です。最新モデルを追いかける以上に、人間側が「判断の理由・例外の経緯」を短い言葉で残しておくことこそが最大の品質保証になります。
例:「見積は 11/03版 が最終合意(11/10版は比較用の不採用案)」
例:「前回納品遅れのお詫びとして、今回のみ送料無料で口頭合意」
例:「先方担当者の漢字は『國本』様。旧ロゴデータは使用不可」
Part 4:明日からどう使い分ける? ニュースへの向き合い方
最後に、個人事業主や小規模チームが明日から迷わず動けるよう、「今すぐ取り入れること」と「無理に変えなくていいこと」を整理します。今回の検証は開発ツール上で行いましたが、「網羅のGemini上位・引き算と文章のClaude・安全点検のGPT」という性格の違いは、普段ブラウザ版のチャット画面(Gemini / Claude / ChatGPT)で相談相手を選ぶときにもそのまま活かせます。
今すぐ試せる・仕事に活かせること
- 条件の多い業務画面の設計・本実装を Gemini 4 Carbon に任せる:今回の12種条件分岐や時刻計算を含む画面実装で、従来のArgon以上の粘り強さと現場配慮を確認できました(複数ファイル改修への適性は今後検証)。
- 「引き算したい顧客画面」や「勝負の文章」には Opus 5.5 を重ねる:作った画面が複雑だと感じたら、Opus 5.5 に「文字入力や選択肢をどこまで削れるか?」と壁打ちするのが効果絶大です。
- 自分の仕事の「定番お題」を一度だけ複数モデルに投げて比べる:ベンチマークの点数を見るより、普段のメール文や画面案を同じ条件で一度比べるだけで、「この仕事はこの相棒」という肌感覚がつかめます。
今は様子見・焦らなくていいこと
- 日常のちょっとした相談まで全部 Carbon に固定しない:今回のTask Aでは約3分22秒(202秒)かかっており、日々のタスク確認や軽い調べ物は Flash や Argon の方が圧倒的に快適です。
- 契約プランを無理に増やさず、今の自分の仕事のボトルネックを見る:どの最新モデルも「社内の整理整頓と引き継ぎメモ」があって初めて力を発揮する点はまったく変わりません。
まりなさん なるほど〜! 「どれか1つが優勝」じゃなくて、テキパキ動くFlashやArgon、緻密に形にしてくれるCarbon、思い切って引き算してくれるOpus 5.5、しっかり点検してくれるGPT-6.1 Solって、本当に頼もしいチームみたいですね!
けんさん ほんとそうだね。カタログの点数だけ眺めていると迷うけど、自分たちの実際の仕事のお題を投げてみると、それぞれの肌感覚がよく分かるよね。さっそく、お客さん向けの予約画面づくりや日々の文章作成から、このチーム編成で動いてみよう。